- 登入
- 註冊
申請上教育部青年署的「青年百億海外圓夢基金計畫」之後,我的見學對象是推動「笑與健康」的笑いイノベーション学会(笑的創新學會)。有一件事我從申請的第一天就很清楚:我聽不懂日文。我跟我的日文老師一週上兩堂日文課,進度還在五十音和「は」跟「が」的差別;但跟日本人開線上會議、參加他們每週的線上笑いクラブ、在月例會上分享,每一場都是全日文。每一場都需要口譯,可是口譯不會永遠在。於是我在圓夢計畫執行的過程中,自己動手做了一台「即時口譯機」。
這篇不是教學文件,而是一個不會日文、也不是工程師的喜劇演員,為了把話說給日本人聽,在三個星期裡把一個工具從「堪用」改到「能上場」的過程:做了兩版、踩了一堆坑,最後在口譯臨時缺席的那天,靠它在 31 個日本人面前撐完一整場分享。那一場的故事,我寫在口譯臨陣缺席,我在 31 個日本人面前用自製翻譯機撐完第一場分享;這篇專門聊這台機器是怎麼長出來的。
工具不是為了炫技,是因為我真的聽不懂,而見學不能等我學會日文才開始。
先把時間軸攤開,你會發現這台機器沒有一個功能是「規劃」出來的,每一步都對應到一場真實的會議。
| 日期 | 當時要面對的場合 | 工具長出了什麼 |
|---|---|---|
| 9 月 1 日 | 第一次參加線上笑いクラブ,全日文 | 第一版:把會議裡的日文變成中文字幕 |
| 9 月 12 日前後 | 月例會分享在即,日文講稿由我的日文老師修訂定稿 | 第二版:簡報+即時字幕+口譯語音三合一 |
| 9 月 13 日試講 | 日本朋友看了說「看不懂」 | 找出三個原因,一口氣改掉,翻譯層換成 Claude |
| 9 月 13 日當天 | 口譯生病缺席,我一個人上場 | 撐完 31 人的月例會分享 |
| 9 月 15 日至 22 日 | 每週的線上聚會、勉強会都開著用 | 字幕列獨立、問答模式、翻譯單位三檔、一鍵啟動 |
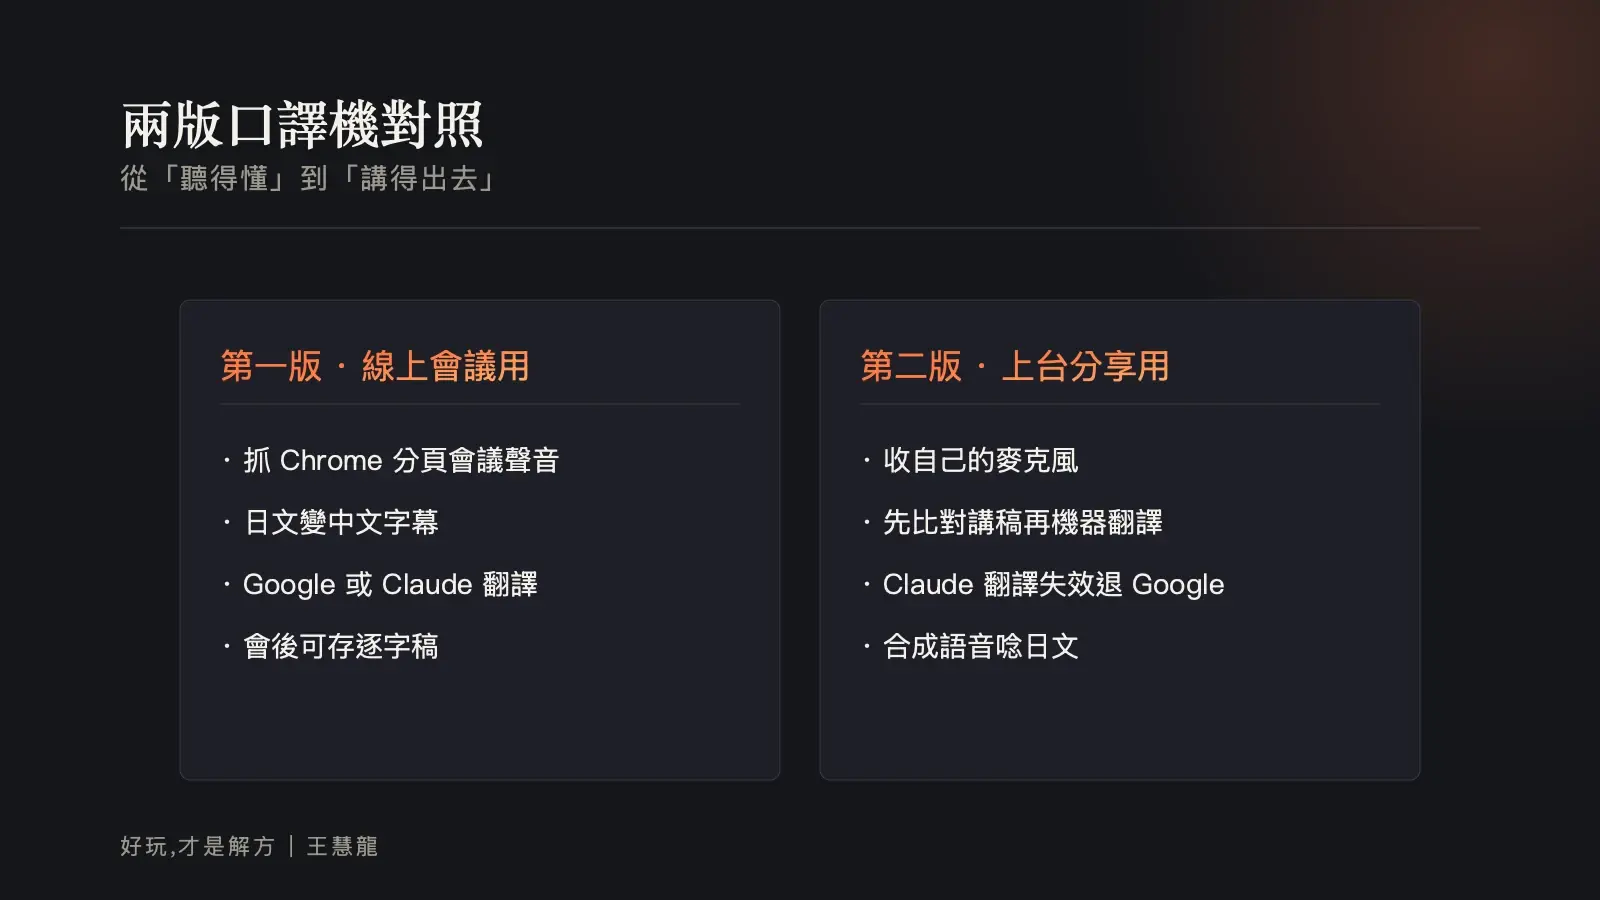
9 月 1 日,我第一次要連上他們的線上笑いクラブ。這是一個每週固定的日文聚會,沒有口譯、沒有簡報,就是一群日本人邊聊邊笑。我要在那裡「聽懂」,才有辦法之後「被聽懂」。所以第一版的目標很單純:把日本人在會議裡講的日文,變成我看得懂的中文字幕。
做法說起來不複雜。我讓瀏覽器直接抓 Chrome 分頁裡的會議聲音,把聲音切成很小的片段,即時送到 ElevenLabs 的 Scribe 語音辨識;辨識出來的日文句子,再丟去翻譯。翻譯這一層我設計成兩條路:有 Claude 的金鑰就走 Claude,沒有就用 Google 翻譯的免費端點。當時我手上還沒有 Claude 的金鑰,所以第一版實際上是靠 Google 撐的。畫面上黃色是正在辨識的日文與暫譯,句子定稿後變成白色中文加灰色日文,會後還能把整場逐字稿存下來。
第一版也有一個天生的限制:它只抓得到 Chrome 分頁的聲音。如果對方用的是桌面版的會議軟體,它就一句都收不到。我當時留了兩條土法:把喇叭外放、讓麥克風去收(會混到自己的聲音),或者裝一個虛擬音訊裝置把系統聲音接過來。
它就是一個「聽」的工具,我完全沒想過要用它來「講」。但它讓我第一次不靠口譯就跟得上一場全日文的線上聚會,也讓我在那一場親耳聽見學會的代表理事用英文恭喜我拿到經費。那個當下我心裡想的是:這條路走得通。
真正的轉折是 9 月 13 日的月例會分享。我要在 31 個日本人面前講 35 分鐘,主題是「放掉自己吧,用笑跟喜劇找回自己」。講稿是我先寫中文、再由我的日文老師一句一句修成好發音的日文定稿,原本也由她口譯。但我心裡一直有個備案:萬一口譯出狀況,我要能自己講中文、畫面自動出日文字幕,而且觀眾看到的日文,最好就是老師修過的那個版本,而不是機器現翻的。
於是第二版長成了「簡報+即時字幕+口譯語音」三合一。這次收的不是會議聲音,而是我自己的麥克風。簡報每一頁是一張圖加日文定稿大字,旁邊小字是給我自己看的中文提示。字幕的邏輯我改成兩段式:我講的中文先跟講稿比對,相似度過了門檻就直接顯示老師修訂過的那句日文定稿,畫面上還會標「講稿」告訴我這句對上了;對不上(像臨場的補充、問答)才走機器翻譯,並套上一份我先整理好的專有名詞對照表,例如「笑いヨガ」「回想法」這類詞不准機器亂翻。
另外加了「口譯語音」模式:我講完一句中文,電腦用 ElevenLabs 合成的日文人聲把定稿唸出來。這裡踩到第一個好玩的坑:合成語音一唸,麥克風就把它收進去,辨識成日文,再翻回中文,變成自己跟自己對話的迴圈。解法是唸的時候讓麥克風送出靜音,唸完再恢復。還有一個給我自己的小功能:日本人用日文提問時,畫面大字顯示日文原文、小字給我看中文,讓我接得上問答。每一場字幕全都記錄成文字檔,這個習慣後來救了我很多次。
| 項目 | 第一版(9/1 線上會議用) | 第二版(9/13 分享用) |
|---|---|---|
| 解決的問題 | 聽不懂日本人在講什麼 | 沒有口譯也要講給日本人聽 |
| 聲音來源 | Chrome 分頁的會議聲音 | 我自己的麥克風 |
| 翻譯方向 | 日文 → 中文字幕 | 中文 → 日文字幕,日文提問 → 中文提示 |
| 翻譯邏輯 | 直接機器翻譯 | 先比對講稿定稿,對不上才機器翻譯加詞彙表 |
| 翻譯引擎 | Google 免費端點(可選 Claude,當時沒金鑰) | Claude API,失效自動退回 Google |
| 額外功能 | 存逐字稿 | 簡報一體、合成語音口譯、問答模式、字幕紀錄 |
| 啟動方式 | 開終端機下指令 | 桌面一個啟動檔,先起伺服器、就緒才開瀏覽器 |
上場前我找日本朋友試講了一次。我自己看畫面覺得很順:中文進、日文出,一句接一句。回饋卻很直接:即時翻譯看不懂。這句話比任何錯誤訊息都有用,因為它逼我從觀眾的位置看畫面,而不是從做的人的位置。我回頭去翻那場的字幕紀錄,一行一行對,找到三個原因。
第一,辨識還沒講完的半句話,我也急著翻給觀眾看。語音辨識是邊聽邊吐字的,一句話會先出現一個「暫定版」,講完才有「定稿版」。我把暫定版也翻成日文丟上畫面,結果觀眾看到的是不停閃動、意思不完整、下一秒又整句換掉的日文。對我來說是「很即時」,對觀眾來說是「看不完」。
第二,Google 翻譯是逐字直譯。我講話的節奏是喜劇演員的節奏,口語、跳躍、帶情緒,Google 一翻就變得又硬又怪,日本朋友要花力氣去猜我的意思,笑點也就沒了。
第三,最隱形的一個:語音辨識輸出的中文是簡體字。我的講稿比對用的是繁體,於是明明講的就是講稿上的句子,比對卻一句都對不上,全部掉到品質較差的機器翻譯去。我花最多心血整理的老師定稿,觀眾一句也沒看到。這個坑我完全是靠紀錄檔才發現的,畫面上根本看不出來。
三個問題,三個改法:暫定版只顯示灰色的中文原文,不翻,等定稿再翻;太短的碎片先暫存兩秒多,併到下一句再一起翻;辨識結果先做簡轉繁再去比對講稿。至於翻譯品質,我決定不再靠 Google,改接 Claude 的 API。
「看不懂」三個字,是這個工具收過最好的需求文件。
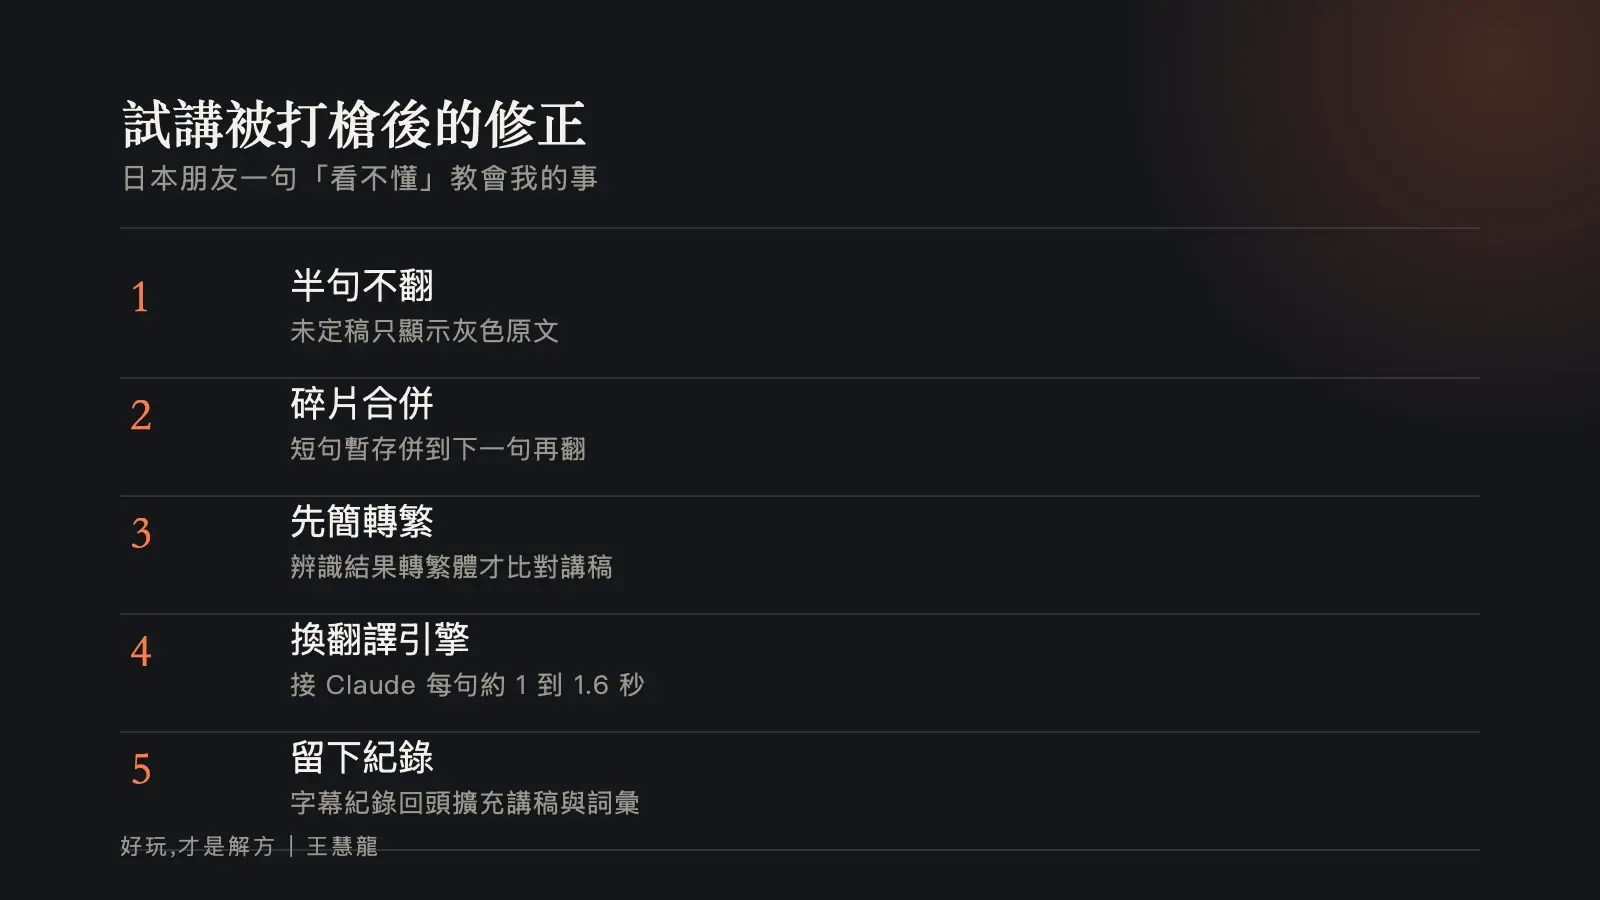
「翻譯層換成 Claude」寫起來一行,做起來繞了一圈。我當時電腦上沒有 API 金鑰,就先試了兩條看起來省事的路。第一條是把桌面版的 Claude 工具常駐在背景當翻譯機:結果每一句要等 3 到 14 秒,而且模型有時候會把中文原文照抄回來,不翻。對線上會議來說,這已經不是慢,是不能用。第二條是找免金鑰的免費翻譯服務,也拿不到能用的通行證。
最後我還是老老實實去申請了金鑰,放進工具的設定檔,翻譯自動切成 Claude,每句大約 1 到 1.6 秒;萬一金鑰失效或服務出錯,自動退回 Google,不會讓畫面空掉。接上之後又冒出一個讓我笑出來的坑:日本人問我台灣怎麼推廣笑いヨガ,AI 沒有翻譯,而是很熱心地開始回答問題。那一刻我才意識到,我請來的不是翻譯,而是一個太想幫忙的助理。提示詞裡明白寫下「你是翻譯機,不是對話對象」,它才安分。
簡轉繁也有它的眉角:只能對中文做。日文裡的「台湾」是他們的寫法,如果一起被轉成「臺灣」,日本人反而看不習慣。所以轉換只套在辨識出來的中文上,日文原封不動。
這些全都是試講之後、上場之前改的。而改完的隔天早上,我接到消息:口譯生病了。前一晚我把試講找出來的問題一個一個修掉,修到深夜,本來只是想讓字幕好看一點;沒想到隔天它從「備案」變成「唯一方案」。
兩版加起來,真正花時間的不是主架構,而是一堆沒人會事先告訴你的小坑。我把印象最深的整理成一張表,每一條都是當時真的卡住、真的查、真的解掉的。
| 踩到的坑 | 當時怎麼卡 | 怎麼查、怎麼解 |
|---|---|---|
| Google 免費端點被擋 | 翻到一半開始回錯誤,再來直接跳出要求驗證的頁面 | 查紀錄發現是端點被限流;換成另一個端點並模擬瀏覽器身分,再留一條備援端點 |
| 語言偵測判錯 | 把我的中文判成英文,翻譯方向整個反了 | 不靠服務偵測,本機用「有沒有假名、有沒有漢字」的簡單規則自己判 |
| 簡體字害比對失效 | 講稿一句都對不上,畫面上全是機器現翻 | 翻字幕紀錄才發現是簡體;辨識結果先簡轉繁,但只轉中文不動日文 |
| 暫譯閃爍 | 觀眾看到不停跳動、下一秒又換掉的日文 | 暫定版只顯示灰色原文不翻;短碎片暫存併到下一句 |
| AI 直接回答問題 | 日本人提問,AI 不翻譯反而熱心作答 | 提示詞明寫「你是翻譯機,不是對話對象」 |
| 用桌面版 AI 工具當翻譯 | 每句等 3 到 14 秒,還會把原文照抄回來 | 放棄,改接正式的 API,並設好失效退回 Google |
| 合成語音被自己收音 | 電腦唸日文,麥克風收進去再翻回中文,無限迴圈 | 唸的時候麥克風送靜音,唸完恢復 |
| 只能抓 Chrome 分頁聲音 | 對方用桌面版會議軟體就收不到 | 喇叭外放給麥克風收,或裝虛擬音訊裝置 |
| 伺服器沒起來頁面打不開 | 上場前手忙腳亂,開了瀏覽器卻一片空白 | 做一個桌面啟動檔:先起伺服器、確認就緒才開瀏覽器,並提醒視窗不能關 |
回頭看這張表,有一半的坑跟「AI」無關,是聲音怎麼進來、字怎麼顯示、人怎麼操作這種很土的事。可是每一個都足以讓上場那天開天窗。
9 月 13 日那場,這台機器撐完全程,31 個日本人透過那行字幕聽懂了我要說的話,代表理事在總結時說了一句讓我記一輩子的話。但我沒有就此收工。之後每一場線上聚會、勉強会我都開著它,字幕紀錄會存下來,會後拿來擴充講稿比對句與詞彙表;工具越用,認得的句子越多。9 月 15 日兩場之後,我甚至從紀錄裡萃取出一百多條他們常用的日文句子,變成我自己的學習教材。
最有感的一次調整是「翻譯單位」。一開始我嫌它一大段講完才翻,跟不上;改成逗號就翻之後,遇到語速快的日本人,又變成半句半句地跳。這兩個抱怨都是我自己在真實會議裡提出來的,也都是對的,只是場合不同。最後定案成三檔可以在工具列切換。
| 翻譯單位 | 什麼時候切句 | 適合的場合 |
|---|---|---|
| 整段 | 對方停頓超過設定秒數才翻 | 對方講得慢、一段一段講的時候,譯文最完整 |
| 整句(預設) | 句號或問號才切,並多等幾個字確認句號是穩的;太長沒句號才退到逗號 | 一般會議,快慢兼顧 |
| 碎片 | 逗號就切 | 對方語速很快、句子很長,寧可快也不要等 |
這種細節不是坐在電腦前想得出來的,是被真實的會議逼出來的。9 月 22 日我把它當面示範給一位專業口譯看,她說這是她目前看過最有創意的做法。我不覺得它能取代口譯,十月赴日的實體場合我還是會請真人;但它讓我在口譯不在的每一個線上場合,都能自己站上去。
我不是工程師,也不是為了做軟體才做軟體。我只是想把話說給對方聽,然後一步一步把擋在中間的東西搬開。
回頭看,這台口譯機不是計畫書裡的項目,它是圓夢計畫執行中被逼出來的東西:因為要開會,所以做了第一版;因為要上台,所以長出第二版;因為日本朋友說看不懂,所以熬夜改;因為口譯缺席,所以它被推上場;因為之後每週都要用,所以它到今天還在改。每一步都不是規劃好的,卻每一步都有一個真實的人在等我把話說清楚。
如果你也在準備一趟海外見學,語言不通、工具不完美、人力可能出狀況,都不是不能開始的理由。先動手做一個堪用的版本,把它帶到真實場景裡,讓對方告訴你哪裡不行,再改。從申請到上場的整段路,可以從青年百億海外圓夢基金計畫怎麼申請?計畫書到面試的完全指南看起。
以下是我查了幾份 2026 年即時語音翻譯的技術文章之後,整理出來的通用建議。它們不是我的獨門發現,而是這個領域的共通經驗;我把它們跟自己踩過的坑對照著寫,給也想動手的你。
作者手記:這台口譯機至今還在改,每開一次會就長一點。寫下來不是為了教人寫程式,而是想說:語言不通的人,也可以靠自己搭一座橋。文中提到的翻譯服務與模型均為當時的實際使用狀況,日後可能更換;口譯朋友的評語屬私下交流語境,特此說明。